> ## Documentation Index
> Fetch the complete documentation index at: https://docs.zylon.ai/llms.txt
> Use this file to discover all available pages before exploring further.
# Monitor del sistema
> Supervisa en vivo los recursos del host y la carga del servicio de modelos desde Backoffice.
## Resumen
El Monitor del sistema ofrece a los Operadores una vista en vivo de la presión sobre los recursos del host y de la actividad del servicio de modelos de IA. Úsalo para detectar presión en CPU, memoria, disco, GPU o colas de inferencia mientras la plataforma está en funcionamiento.
La página está disponible en **Backoffice > Platform > System Monitor** cuando la [función Monitor del sistema](/es/operator-manual/configuration/features/feat-system-monitor) está habilitada.
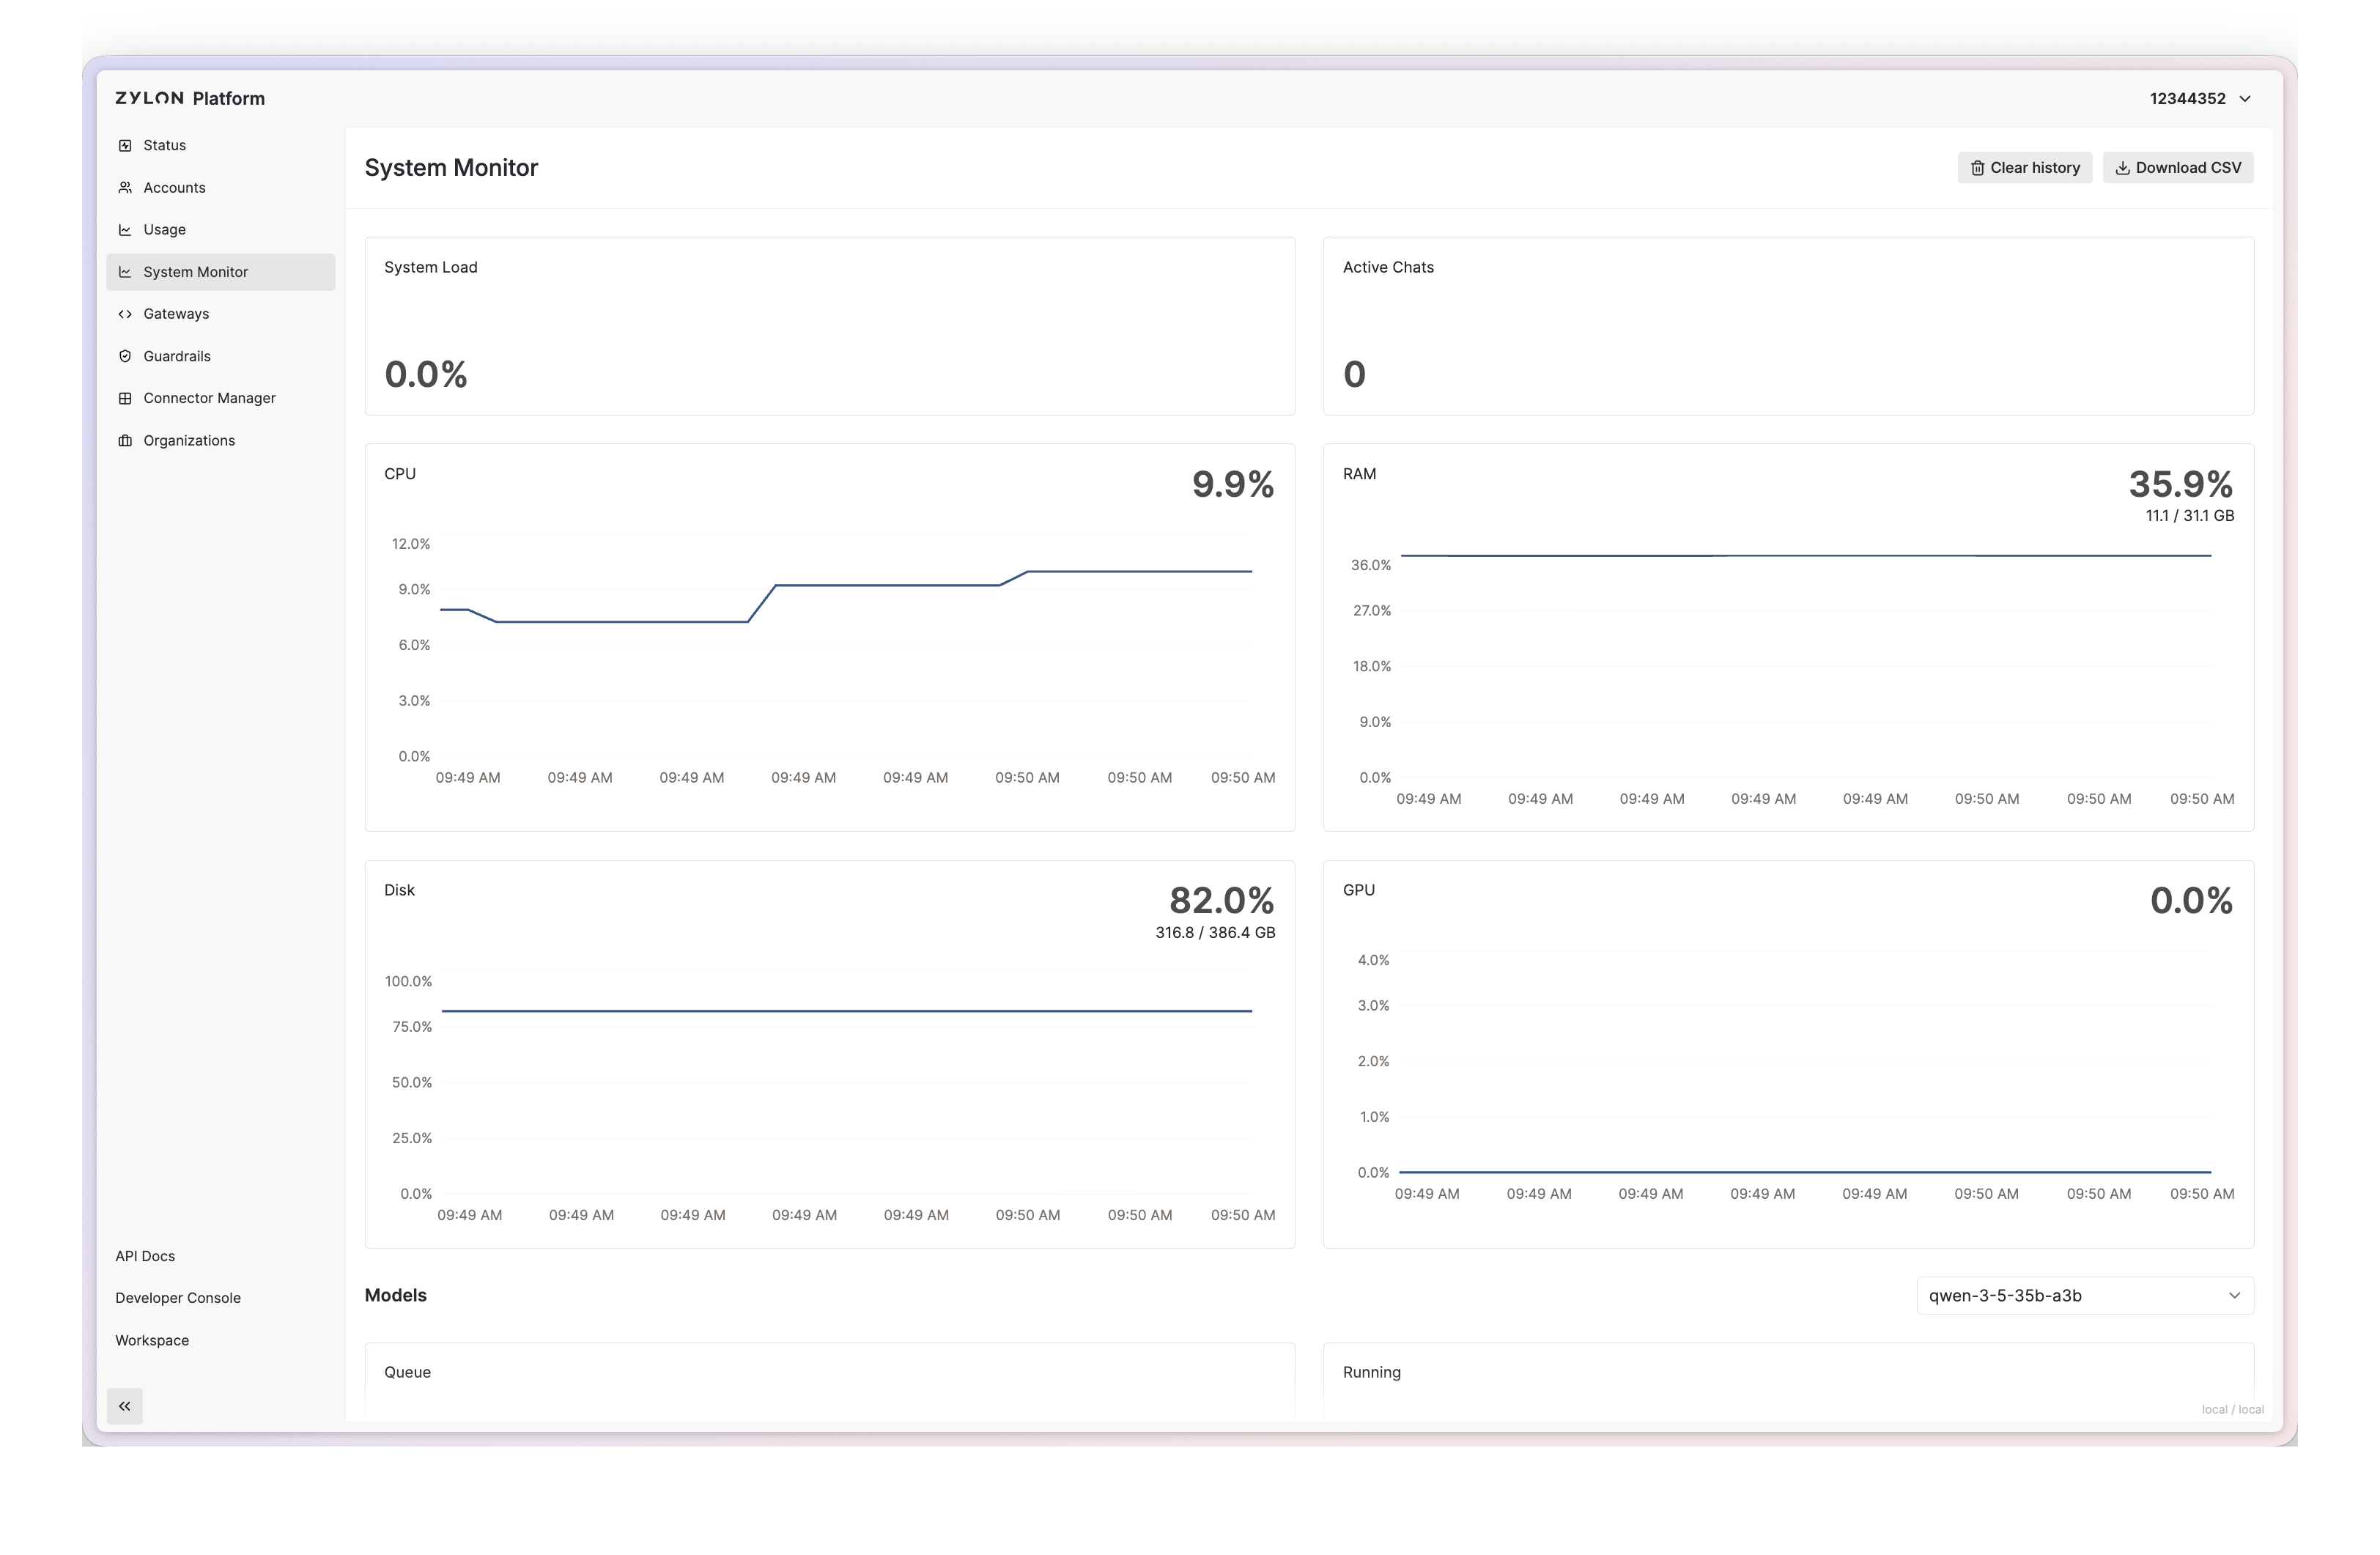 El diseño exacto puede variar entre versiones de Zylon.
## Información disponible
Las métricas se actualizan una vez por segundo. Los gráficos conservan las 30 muestras más recientes, incluidas las muestras recientes que se recuperan al abrir la página.
### Métricas del sistema
| Métrica | Qué muestra |
| - | - |
| **System Load** | La mayor presión normalizada entre GPU, solicitudes de inferencia, CPU y RAM. La GPU alcanza la presión máxima al 80 %; las solicitudes en ejecución más las encoladas, al llegar a 60; CPU y RAM contribuyen cuando el uso supera el 95 %. |
| **Active Inferences** | Inferencias de chat que se están procesando en la plataforma. |
| **Disk** | Porcentaje usado y capacidad total del sistema de archivos que almacena los datos de Zylon. |
| **CPU** | Uso actual de CPU del host y su historial reciente. |
| **GPU** | Uso general actual de cómputo de GPU y su historial reciente. |
| **RAM** | Uso actual de memoria del host, GB usados y totales, e historial reciente. |
| **VRAM** | Uso actual de memoria de GPU en todas las GPU, GB usados y totales, e historial reciente. |
### Métricas por modelo
Selecciona un modelo cargado para consultar:
| Métrica | Qué muestra |
| - | - |
| **Queue Inferences** | Solicitudes en espera en Triton o en el planificador del backend del modelo. |
| **Running Inferences** | Solicitudes que se están ejecutando en el backend del modelo. |
| **Tokens/sec** | Velocidad de generación de tokens de salida calculada entre muestras consecutivas. |
| **GPU Memory Usage** | VRAM asignada al modelo seleccionado como porcentaje de la VRAM total. |
| **GPU Compute** | Uso de los núcleos de cómputo de la GPU atribuido al modelo seleccionado. |
| **GPU Memory Bandwidth** | Uso del bus de memoria de la GPU atribuido al modelo seleccionado; no es lo mismo que la VRAM asignada. |
## Fuentes de datos y limitaciones
* CPU y RAM proceden de las métricas del nodo de Kubernetes cuando están disponibles, con lecturas del host como alternativa.
* El uso de disco corresponde al sistema de archivos que contiene `/var/zylon`.
* Los datos de GPU, VRAM y servicio de modelos proceden del endpoint de métricas Prometheus de Triton.
* Las métricas de GPU por modelo dependen de métricas de GPU por proceso. Los despliegues que no las exponen muestran valores a cero.
* La página es una vista operativa en vivo, no un informe histórico persistente. Al recargarla se solicitan de nuevo las últimas muestras disponibles.
* **System Load** es una señal instantánea para visualización. La protección frente a sobrecarga también tiene en cuenta el uso sostenido de recursos y los umbrales del despliegue.
This documentation is built and hosted on [Mintlify](https://mintlify.com), a developer documentation platform.